Domain 6066.de kaufen?
Wir ziehen mit dem Projekt
6066.de um.
Sind Sie am Kauf der Domain
6066.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain 6066.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
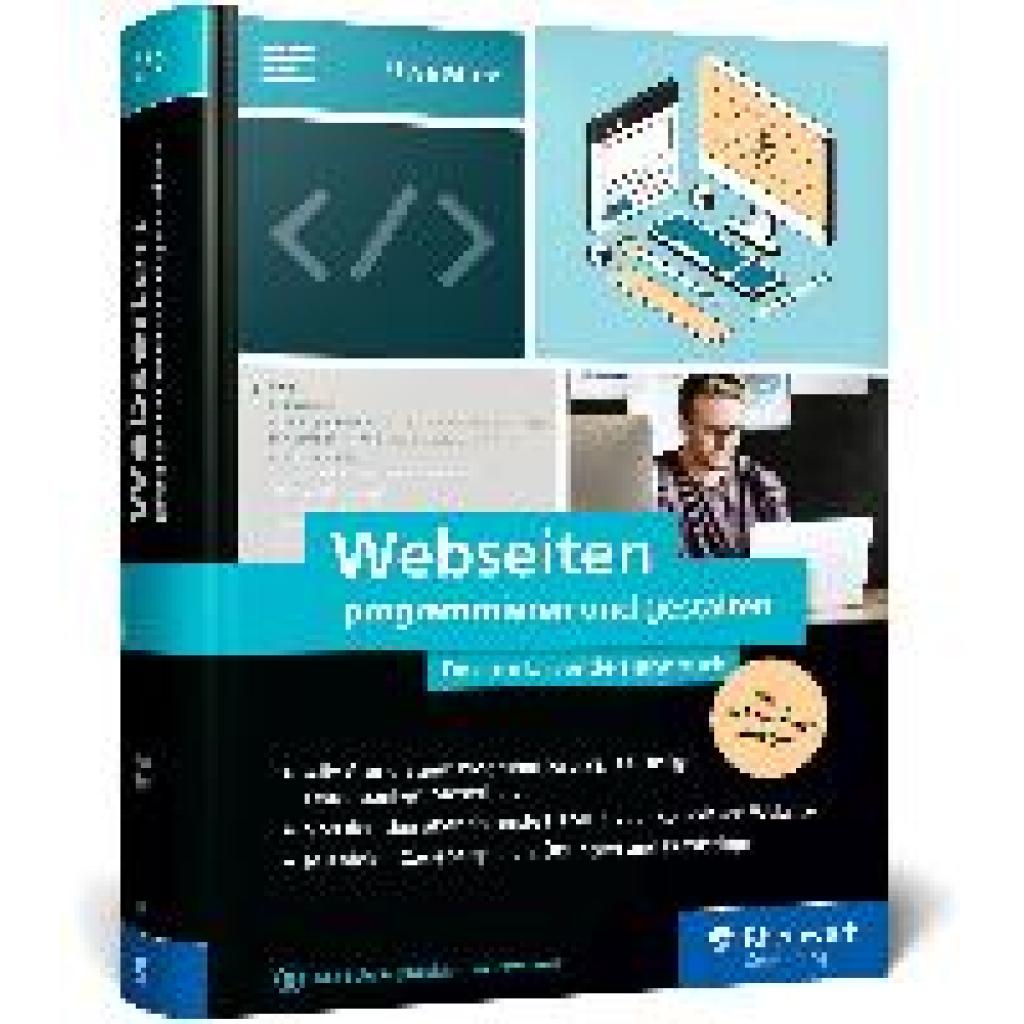
Mutz, Uwe: Webseiten programmieren und gestaltenWebseiten programmieren und gestalten , Das umfassende Handbuch für eine rundum gute Ausbildung zum Webseiten-Profi , Sport-Stoßdämpfer > Sportfederung , Erscheinungsjahr: 20240503, Produktform: Leinen, Titel der Reihe: Rheinwerk Computing##, Autoren: Mutz, Uwe, Seitenzahl/Blattzahl: 1022, Themenüberschrift: COMPUTERS / Web / Design, Keyword: Anfänger; Beruf Studium Ausbildung; CMS Content Management; Fullstack-Entwicklung; Grundlagen Hand-Buch Bücher Lernen Tipp Anleitung; HTML CSS JavaScript; PHP SQL; Programmierung; User Centered Design; User Experience Design; User Storys; Webentwicklung; eigene Website erstellen, Fachschema: Internet / Publishing, Web-Site-Design~Microsoft SharePoint (WebServices, Portal)~Web Services (EDV)~Internet~Surfen (Internet), Fachkategorie: Web-Grafik und -Design~Internet, allgemein~Computernetzwerke und maschinelle Kommunikation, Warengruppe: HC/Datenkommunikation/Netze/Mailboxen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 245, Breite: 181, Höhe: 63, Gewicht: 2048, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin,49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gesundheitsförderung und Gesundheitsberatung. Themenzentrierte Interaktion, die Plattform jameda.de und der systemische Beratungsansatz, TaschenbuchGesundheitsförderung Und Gesundheitsberatung. Themenzentrierte Interaktion, Die Plattform Jameda.de Und Der Systemische Beratungsansatz, Taschenbuch Von J. Villringer, Grin, 978-3-346-88323-0, Seitenanzahl: 249,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie können Webcrawler dazu beitragen, Informationen im Internet effizient zu sammeln und zu katalogisieren?
Webcrawler sind automatisierte Programme, die das Internet nach Inhalten durchsuchen und diese indexieren. Sie können dabei helfen, Informationen aus verschiedenen Quellen zu sammeln und zu strukturieren. Durch die Verwendung von Webcrawlern können Suchmaschinen wie Google relevante Informationen schneller und effizienter bereitstellen. **
-
Wie funktioniert die Indexierung von Webseiten durch Webcrawler und welchen Einfluss hat dies auf die Suchergebnisse von Suchmaschinen?
Webcrawler durchsuchen das Internet nach neuen Inhalten und indexieren Webseiten basierend auf Relevanz und Qualität. Die Indexierung hilft Suchmaschinen dabei, relevante Seiten für Suchanfragen zu finden und in den Suchergebnissen zu präsentieren. Eine gute Indexierung kann die Sichtbarkeit einer Webseite in den Suchergebnissen erhöhen, während eine schlechte Indexierung dazu führen kann, dass die Seite nicht gefunden wird. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **

Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
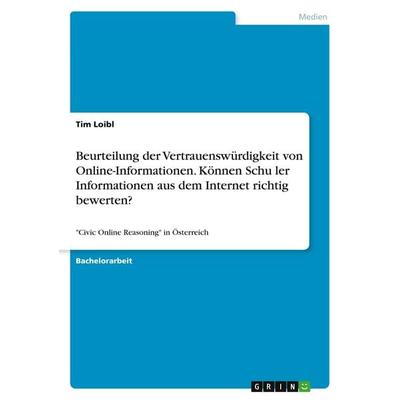
Beurteilung der Vertrauenswürdigkeit von Online-Informationen. Können Schu¿ler Informationen aus dem Internet richtig bewerten?, Taschenbuch von TimBeurteilung Der Vertrauenswürdigkeit Von Online-informationen. Können Schu¿ler Informationen Aus Dem Internet Richtig Bewerten?, Taschenbuch Von Tim Loibl, Grin, 978-3-346-16808-5, Seitenanzahl: 10847,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Mutz, Uwe: Webseiten programmieren und gestaltenWebseiten programmieren und gestalten , Das umfassende Handbuch für eine rundum gute Ausbildung zum Webseiten-Profi , Sport-Stoßdämpfer > Sportfederung , Erscheinungsjahr: 20240503, Produktform: Leinen, Titel der Reihe: Rheinwerk Computing##, Autoren: Mutz, Uwe, Seitenzahl/Blattzahl: 1022, Themenüberschrift: COMPUTERS / Web / Design, Keyword: Anfänger; Beruf Studium Ausbildung; CMS Content Management; Fullstack-Entwicklung; Grundlagen Hand-Buch Bücher Lernen Tipp Anleitung; HTML CSS JavaScript; PHP SQL; Programmierung; User Centered Design; User Experience Design; User Storys; Webentwicklung; eigene Website erstellen, Fachschema: Internet / Publishing, Web-Site-Design~Microsoft SharePoint (WebServices, Portal)~Web Services (EDV)~Internet~Surfen (Internet), Fachkategorie: Web-Grafik und -Design~Internet, allgemein~Computernetzwerke und maschinelle Kommunikation, Warengruppe: HC/Datenkommunikation/Netze/Mailboxen, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Länge: 245, Breite: 181, Höhe: 63, Gewicht: 2048, Produktform: Gebunden, Genre: Mathematik/Naturwissenschaften/Technik/Medizin,49,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie können Webcrawler dazu beitragen, Informationen im Internet effizient zu sammeln und zu katalogisieren?
Webcrawler sind automatisierte Programme, die das Internet nach Inhalten durchsuchen und diese indexieren. Sie können dabei helfen, Informationen aus verschiedenen Quellen zu sammeln und zu strukturieren. Durch die Verwendung von Webcrawlern können Suchmaschinen wie Google relevante Informationen schneller und effizienter bereitstellen. **
-
Wie funktioniert die Indexierung von Webseiten durch Webcrawler und welchen Einfluss hat dies auf die Suchergebnisse von Suchmaschinen?
Webcrawler durchsuchen das Internet nach neuen Inhalten und indexieren Webseiten basierend auf Relevanz und Qualität. Die Indexierung hilft Suchmaschinen dabei, relevante Seiten für Suchanfragen zu finden und in den Suchergebnissen zu präsentieren. Eine gute Indexierung kann die Sichtbarkeit einer Webseite in den Suchergebnissen erhöhen, während eine schlechte Indexierung dazu führen kann, dass die Seite nicht gefunden wird. **
Ähnliche Suchbegriffe für Webcrawler
-
Gesundheitsförderung und Gesundheitsberatung. Themenzentrierte Interaktion, die Plattform jameda.de und der systemische Beratungsansatz, TaschenbuchGesundheitsförderung Und Gesundheitsberatung. Themenzentrierte Interaktion, Die Plattform Jameda.de Und Der Systemische Beratungsansatz, Taschenbuch Von J. Villringer, Grin, 978-3-346-88323-0, Seitenanzahl: 249,99 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Die Online-Präsenz gesundheitstouristischer Anbieter. Anforderungen an Webseiten und Entwicklung von Bewertungskriterien am Beispiel derDie Online-präsenz Gesundheitstouristischer Anbieter. Anforderungen An Webseiten Und Entwicklung Von Bewertungskriterien Am Beispiel Der Kreuzfahrtindustrie, Taschenbuch Von Anonymous, Grin, 978-3-346-52757-8, Seitenanzahl: 8447,95 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.